Lo que pasa cuando tienes 52 herramientas
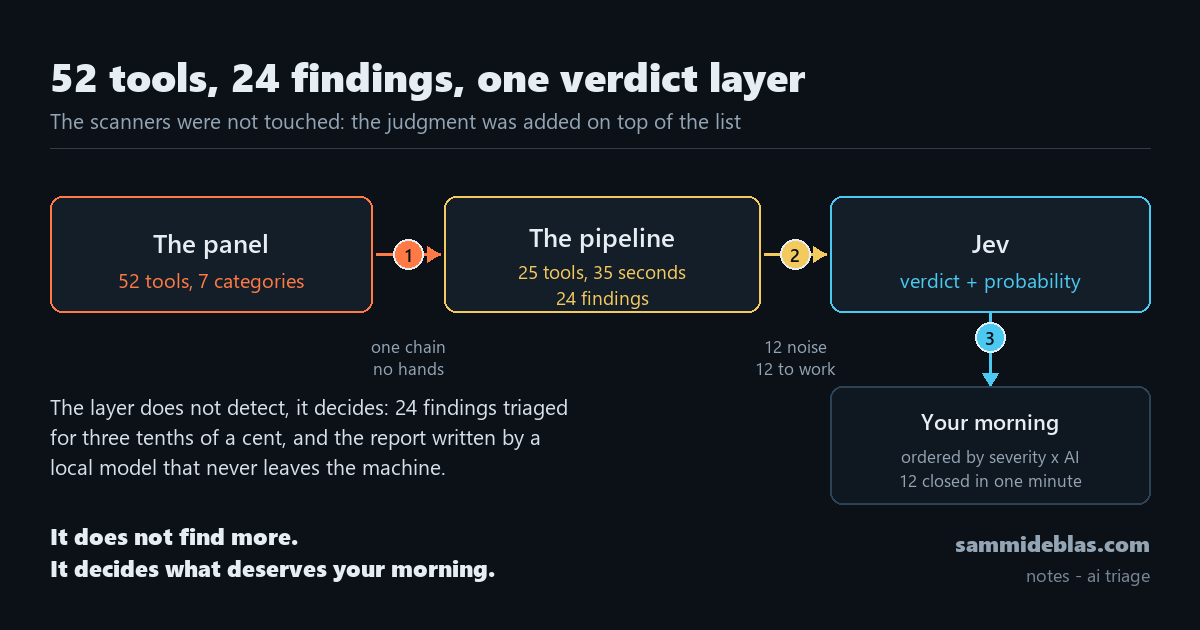
Tengo un panel propio con 52 herramientas de seguridad repartidas en 7 categorías, y no es un juguete.
Escanea puertos, resuelve DNS, mira cabeceras, enumera subdominios, busca secretos, revisa vulnerabilidades y luego tengo otro que audita el propio Windows.
El problema llegó el día que encadené las herramientas en un pipeline y lo lancé entero.
El resultado de esa cadena fue 25 herramientas en 35 segundos y 24 hallazgos sobre la mesa.
Ahí empezó el problema real, que no es encontrar cosas. Es que alguien las mire todas, las ordene y decida cuáles importan antes de que acabe el día.
La tentación era añadir más herramienta, hacerla super compleja e intimidante y era la respuesta equivocada.
Lo que faltaba era una capa de juicio encima de la lista algo que leyera los 24 hallazgos y dijera cuáles son reales, cuáles son ruido y de cuáles no se fía lo suficiente.
Para eso integré Jev, que no es UN LLM pero es una herramienta nueva, JEV el modelo que TypeSafe publicó el 15 de septiembre (Fuente: docs.typesafe.ai).
Jev no genera texto mas bien evalúa un estado contra preguntas tipadas y devuelve una respuesta con una probabilidad asociada y…es exactamente lo que necesitaba, cuando lo vi anunciado dije esto es perfecto (y barato)
Y no toqué ni una línea de los escáneres porque la capa de IA se engancha a la lista de hallazgos que el panel ya agregaba.
Los números
El pipeline nuclear lanzó 25 herramientas en 35,15 segundos y produjo 24 hallazgos.
Jev evaluó los 24 en una sola pasada y separó 12 verdaderos positivos de 12 ruidos.
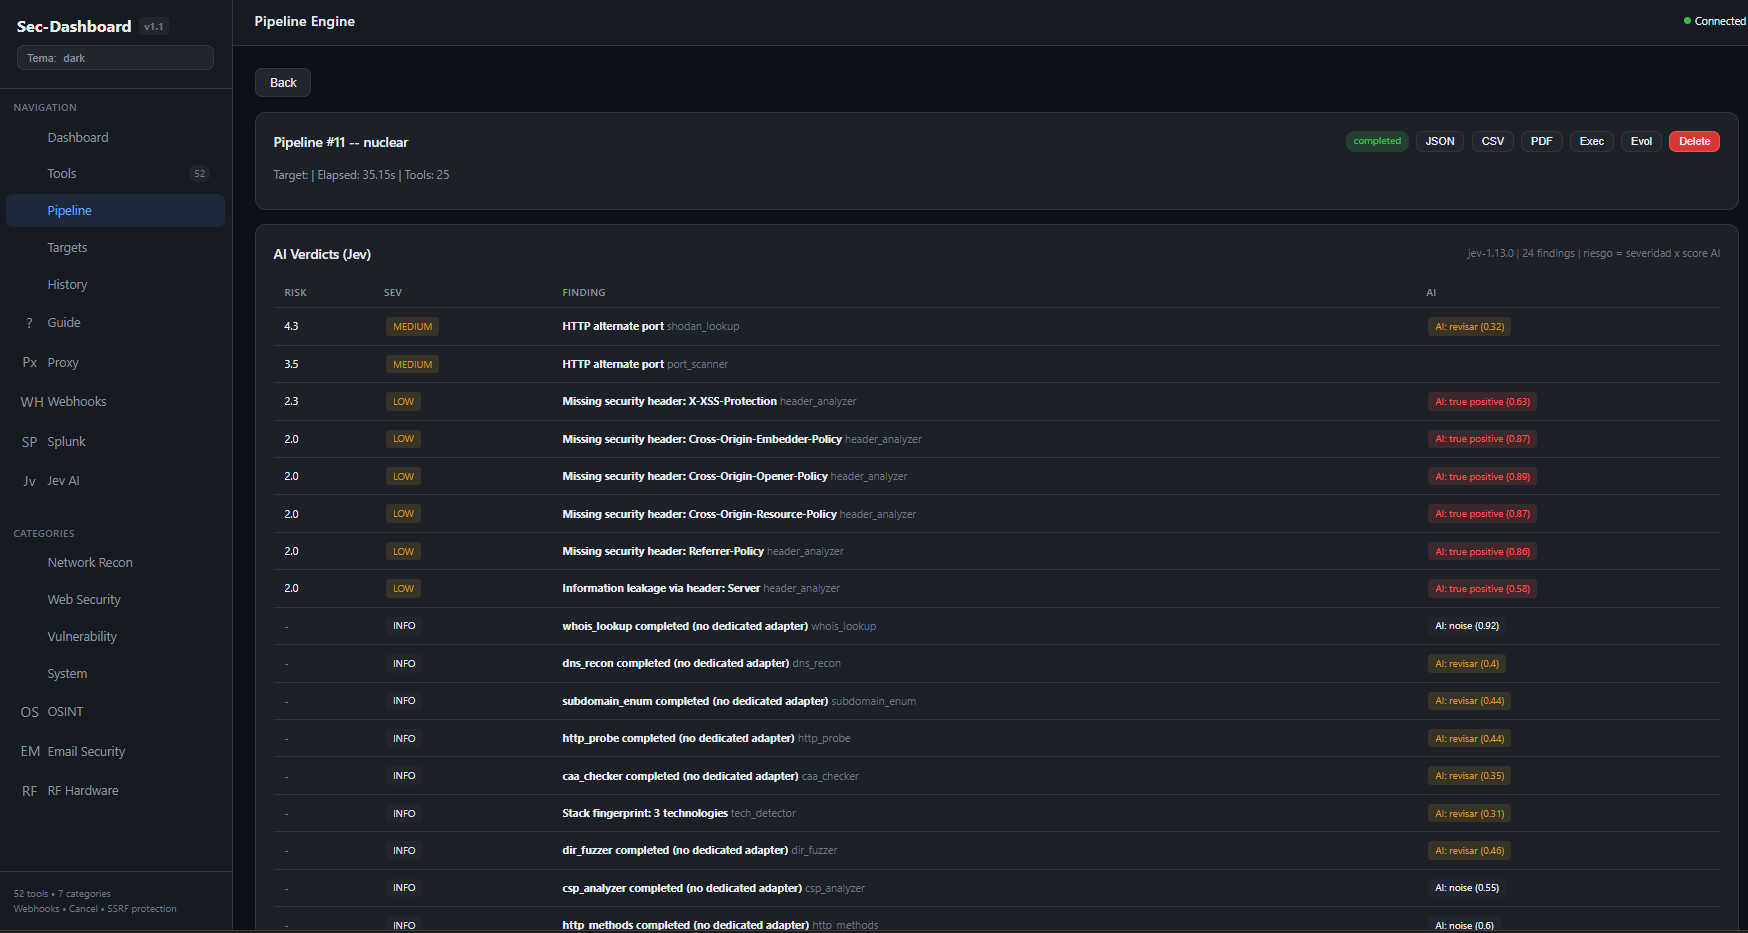
Una minucia de gasto por trabajar con 24 hallazgos.
Ahí se cae el argumento de que la IA no es asequible para un SOC pequeño o grande el coste de la capa de juicio es ruido estadístico al lado del tiempo que ahorra esta bestia, que por cierto esto lleva existiendo desde hace mucho pero alguien ha tenido la buena mano de comerciar.
¿El sistema duda?
Lo que más me convenció no fue un acierto fue un seco 0,32.
Un puerto HTTP alternativo salió con esa confianza, y el panel no lo marcó como amenaza lo marcó como revisar.
Los encabezados de seguridad que faltan salieron con 0,86 y 0,89 esos sí son verdad sin discusión.
Las tareas que simplemente se completaron como el whois o el DNS, salieron como ruido con 0,92.
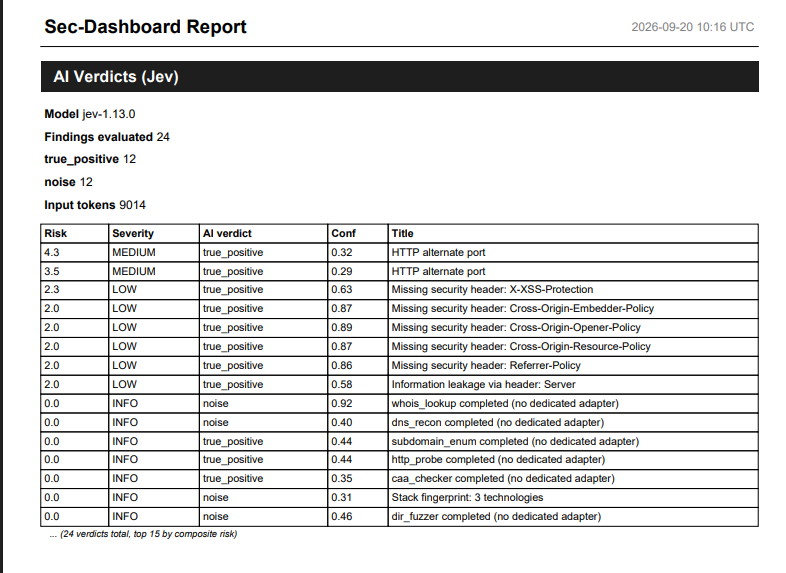
La diferencia entre 0,32 y 0,89 es la diferencia entre una alarma que persigues media hora y una que documentas y cierras.
Después el panel reordena la cola entera por severidad multiplicada por el veredicto de la IA, que es lo que cambia de verdad tu mañana.
El caso que me hizo gracia
La segunda capa vino por el otro lado.
Mi proyecto de auditoría en PowerShell recorre una máquina Windows en 10 módulos y manda sus hallazgos al mismo panel.
Una de esas auditorías marcó 2 amenazas de severidad alta.
La primera era un driver sin firma digital cargado desde la carpeta temporal de mi usuario.
La segunda, un proceso corriendo en memoria cuyo binario ya no estaba en disco.
Leídos en frío, esos dos son un rootkit y una inyección, cualquiera que haya hecho triaje los pondría arriba de la cola.
El driver se llama GPU-Z-v8.sys ( yo pensé en Dragon BALL) y esto es de la herramienta de monitorización de GPU que deja su archivo en la carpeta temporal y el fichero es del 28 de julio con el programa ya ni instalado en el equipo.
Jev le dio 0,76 de confianza y un 24% de probabilidad de falso positivo.
El otro salió con 0,79 y un 21%.
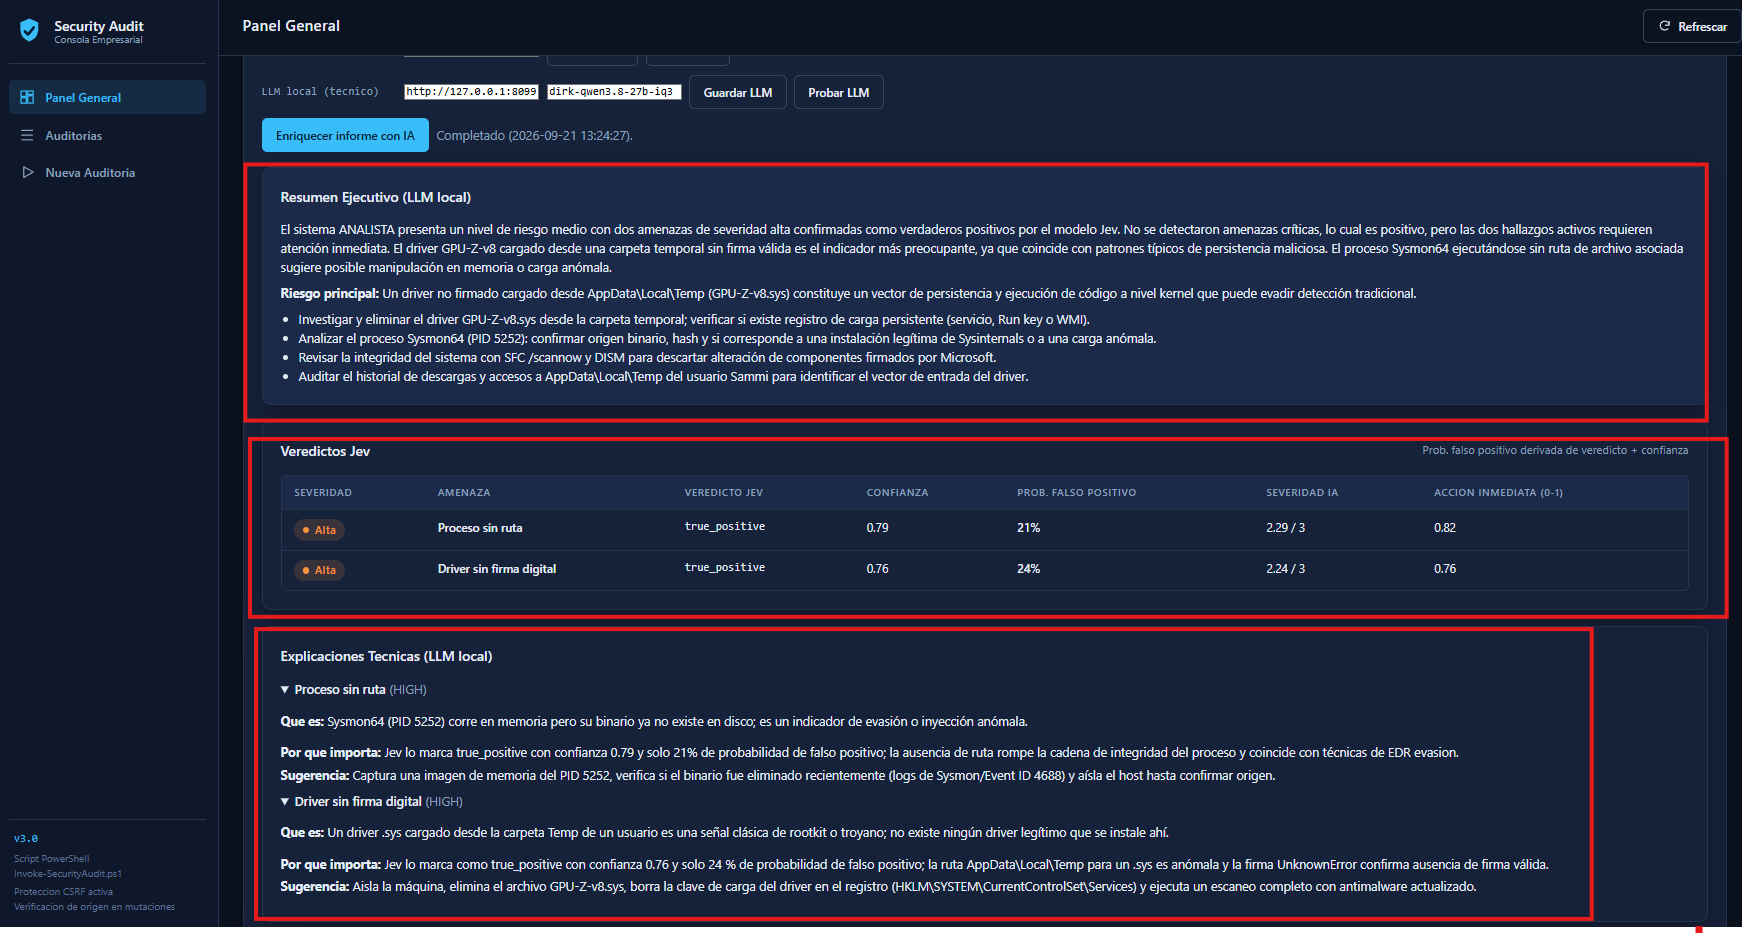
Ese porcentaje es la pieza que ningún modelo de texto me da con esa precisión, porque no me dijo que fuera un rootkit no habla…esto calcula y lo que me dijo que era bastante probable y que había 1 de cada 5 posibilidades de que fuera algo legítimo.
Investigar los dos me llevó menos de 1 minuto, y ese es el trabajo que ya no hago a mano.
Y encima el informe se escribe solo
La tercera pieza no juzga, redacta.
Un modelo local de 27B en mi propia máquina servido con llama.cpp coge los veredictos y escribe el resumen ejecutivo en español más una explicación por hallazgo con qué es por qué importa y qué haría yo ahora mismo.
Nada de eso sale de mi equipo ni un hallazgo ni un nombre de máquina, ni una ruta.
El informe que en una auditoría normal me llevaba 1 hora de redacción sale redactado, en mi idioma y con las acciones priorizadas.
Ok ¿Y entonces qué?
Lo digo antes de que lo pregunte nadie esto es una muestra y 24 hallazgos con 12 falsos positivos puede ser un martes bueno o puede ser suerte.
Falta medir la calibración en español, que es otro idioma y no es lo mismo.
Falta contar los falsos negativos, esos que la capa de juicio manda a ruido y sí eran reales, porque sin ese dato no puedo decir que la capa sea fiable, solo que me está siendo útil.
Y falta llevarlo al visor de registros, donde el estado natural no son hallazgos sino ráfagas de eventos.
Esto es lo que hay un panel de 52 herramientas que termina en 35 segundos y una capa de juicio calibrada que cuesta 4 céntimos de euro.
Un modelo local que redacta el informe y 2 falsas alarmas que este conjunto resolvió en un minuto.
Reflexionen señores