Tres fallos y un mismo patrón
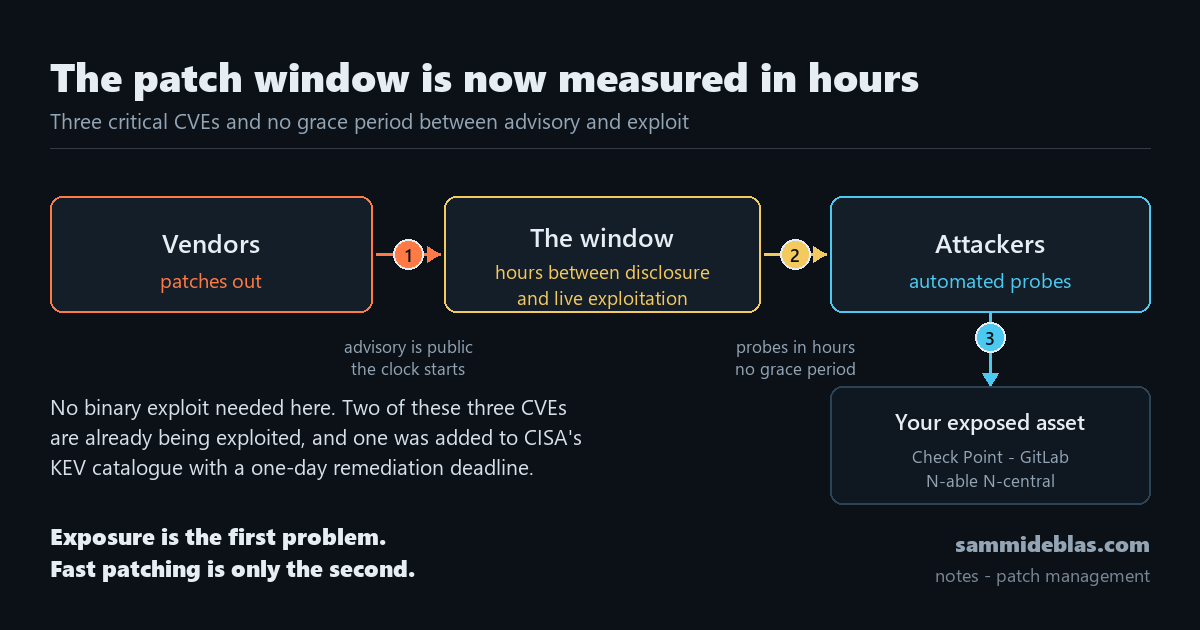
Esquema del caso: entre el aviso público y la explotación ya solo hay horas, y en medio queda tu activo expuesto.
La semana ha dejado tres vulnerabilidades críticas con un rasgo común que conviene mirar despacio.
El 11 de septiembre, Check Point publicó parches para dos vulnerabilidades de ejecución remota de código en sus appliances VPN, CVE-2026-85102 y CVE-2026-85103 (Fuente: securityweek.com).
La primera afecta al Security Gateway y permite ejecutar código sin credenciales.
La segunda alcanza también al Management Server.
El NCSC neerlandés avisó de explotación inminente y la cobertura LivePatch Take 24 cubre R81.20, R82 y R82.10, mientras que el resto de versiones exige subir a R82.20 (Fuente: blog.sied.ar).
La recomendación operativa que acompaña al aviso es concreta, pues conviene restringir los puertos 500, 4500 y 443 a peers solo autorizados.
Ese mismo día… GitLab lanzó parches para CVE-2026-85706, un path traversal en la API de commits con CVSS 10.0. ¡OMG!
El fallo permite leer archivos del servidor sin autenticación. ¡OMG!
Las sondas en producción se detectaron horas después de la divulgación pública, según watchTowr (Fuentes: thehackernews.com, elhacker.net).
Las versiones corregidas son 19.3.2, 19.2.6 y 19.1.8.
El tercer caso es N-able N-central, CVE-2026-86218, un RCE previo a autenticación con CVSS 10.0.
La explotación en vivo entró en el catálogo KEV de CISA con plazo de remediación el 11 de septiembre, y Shadowserver contaba cerca de 1.500 consolas expuestas (Fuente: thehackernews.com).
El patrón
Hay una escena que resume por qué estos tres casos se leen juntos.
En el caso de GitLab, las sondas aparecieron en producción horas después de que el parche fuera público. No hubo ventana de gracia.
Alguien estaba mirando el repositorio de avisos, o tenía un sistema que lo mira por él y actuó antes de que la mayoría de administradores hubiera leído el correo.
¡Eso es lo llamativo!
La divulgación pública ya no marca el inicio de un plazo de días.
Marca el pistoletazo de salida de una carrera que algunos corren con automatización.
El caso de N-able añade otra capa.
CISA incluyó el fallo en su catálogo de vulnerabilidades explotadas con un plazo de remediación de un solo día.
Ese plazo no es retórico, es decir, refleja que la explotación ya estaba ocurriendo cuando se publicó el aviso.
Las 1.500 consolas expuestas que contaba Shadowserver son la superficie donde ese reloj corre.
No es un caso aislado
Los tres casos comparten un patrón que la semana anterior ya había dejado ver con más crudeza.
GreyNoise y SecurityWeek documentaron una campaña con cientos de agentes de IA contra servidores PaperCut NG/MF, encadenando CVE-2026-81578 y CVE-2026-82078 sobre un harness Codex con modelo DeepSeek.
El resultado fueron unas 440 organizaciones comprometidas en 48 países, casi la mitad del sector educativo (Fuente: bleepingcomputer.com, greynoise.io).
Un centro educativo pasó de acceso inicial a Domain Admin en siete minutos.
La conexión no es que los fallos sean iguales, es más bien que el coste de encontrar, probar y desplegar un exploit ha caído.
Un atacante con presupuesto bajo puede alquilar agentes de IA para escanear, generar variantes y validar el exploit en un laboratorio propio antes de lanzarlo.
Lo que antes requería un equipo humano durante días ahora se ejecuta en paralelo y a gran escala.
Por eso la ventana de parcheo se ha reducido, pero no porque los fallos sean más graves, sino porque del otro lado hay más manos, más rápidas y más baratas.
Cuando el agente ataca
Conviene decirlo sin rodeos, aunque duela. Yo tengo la sensación de que estamos perdiendo el control en la defensa desde que los agentes irrumpen en el panorama.
En el caso de PaperCut… los agentes de IA no eran la herramienta defensiva, sino que eran el atacante.
Cientos de instancias orquestadas para descubrir o probar y desplegar exploits contra servidores expuestos.
El harness Codex con modelo DeepSeek es la pieza técnica que lo hace posible sin más… un entorno que ejecuta tareas de forma autónoma sobre un modelo de lenguaje, pero créeme, he probado en mi lab formas sencillas y con modelos locales pequeños que caben en cualquier GPU, y te puedes esconder tras varios proxies, etc… mejor no doy ideas.
Eso cambia la conversación sobre agentes en el SOC.
No es solo que un analista pueda usar un agente para triage.
Es que el mismo tipo de tecnología, con menos supervisión, ya se usa para atacar.
La asimetría es real. Por desgracia, el defensor necesita que todo funcione y el atacante solo necesita un servidor sin parchear.
La lectura propia
Para quien administra estos sistemas, el mensaje es incómodo pero claro.
El parcheo en horas ya no es el mínimo para no aparecer en la lista de víctimas.
La segmentación y el filtrado de salida (egress filtering) siguen siendo los controles que marcan la diferencia cuando el tiempo de exposición se mide en horas, no en días.
Y hay una lección de inventario, y es que las 1.500 consolas de N-able expuestas no estaban escondidas, no… estaban en internet, accesibles.
Lo mismo ocurre con las appliances VPN de Check Point y con las instancias de GitLab.
La superficie expuesta es el primer problema y, por ende, el parcheo es el segundo.
Qué mirar
- Revisa los puertos expuestos. Si gestionas appliances Check Point, restringe los puertos 500, 4500 y 443 a peers autorizados. Si tienes consolas N-able N-central accesibles desde internet, esa es la primera decisión del lunes.
- Comprueba versiones de GitLab. Las versiones corregidas son 19.3.2, 19.2.6 y 19.1.8. Si tu instancia está por debajo y expuesta, el path traversal permite leer archivos sin autenticación.
- Activa telemetría de sondeos. Las sondas de GitLab se detectaron horas después de la divulgación. Un registro de intentos de acceso a rutas de la API de commits te da la señal antes de que el exploit funcione.
Cómo lo probaría en mi laboratorio
Montaría una instancia de GitLab en una máquina virtual aislada, sin exposición a internet, y lanzaría peticiones a la API de commits con rutas manipuladas para ver si el servidor devuelve contenido de archivos fuera del directorio esperado.
Antes de eso, capturaría el tráfico con tcpdump para tener registro de qué peticiones llegan y con qué forma.
La conclusión sería que, si la versión vulnerable responde con contenido de archivos que no debería, el fallo es real y el parche es urgente.
Si responde con error, la versión ya está corregida.
Es una comprobación de una tarde que no requiere nada más que una VM y ganas de leer respuestas HTTP.
Cierre
La ventana entre divulgación y explotación se ha comprimido a horas.
Quien no tenga un proceso de parcheo que funcione en ese plazo está jugando a otra cosa.
La buena noticia es que los controles que marcan la diferencia siguen siendo los mismos de siempre, menos superficie expuesta, parches rápidos y telemetría que avise antes de que el exploit llegue.